2026

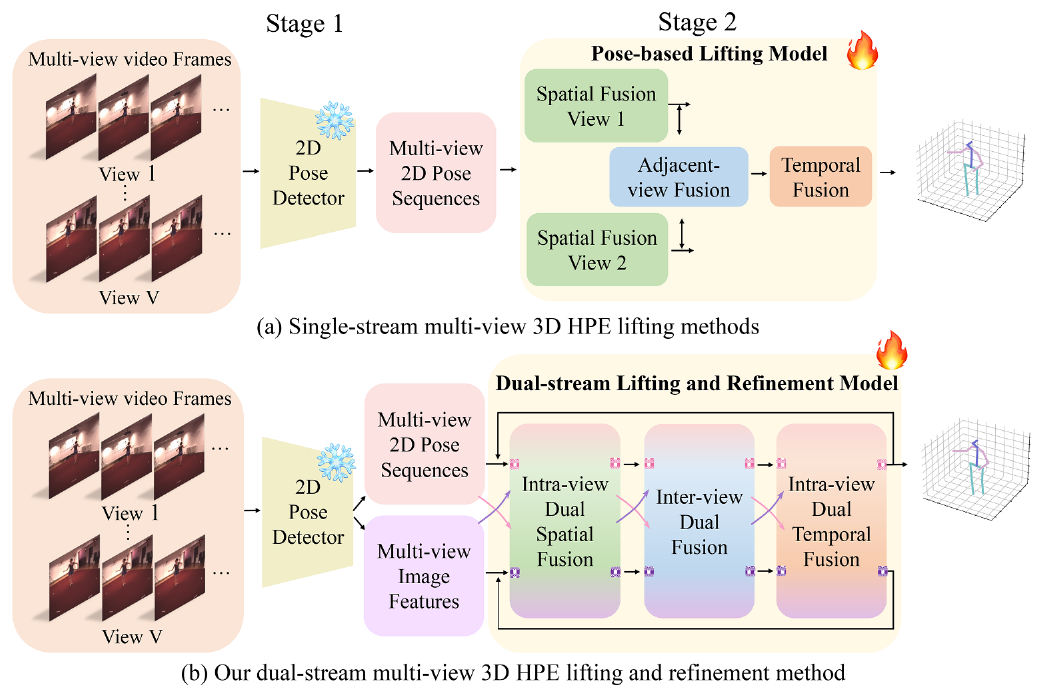
Figure 1: DSVTformer: Dual-Stream Spatial-View-Temporal Transformer for Multi-View 3D Human Pose Estimation

Wanruo Zhang, Mengyuan Liu*, Wenhao Li, Hong Liu. DSVTformer: Dual-Stream Spatial-View-Temporal Transformer for Multi-View 3D Human Pose Estimation. PR, 2026. (通讯作者, 模式识别期刊)

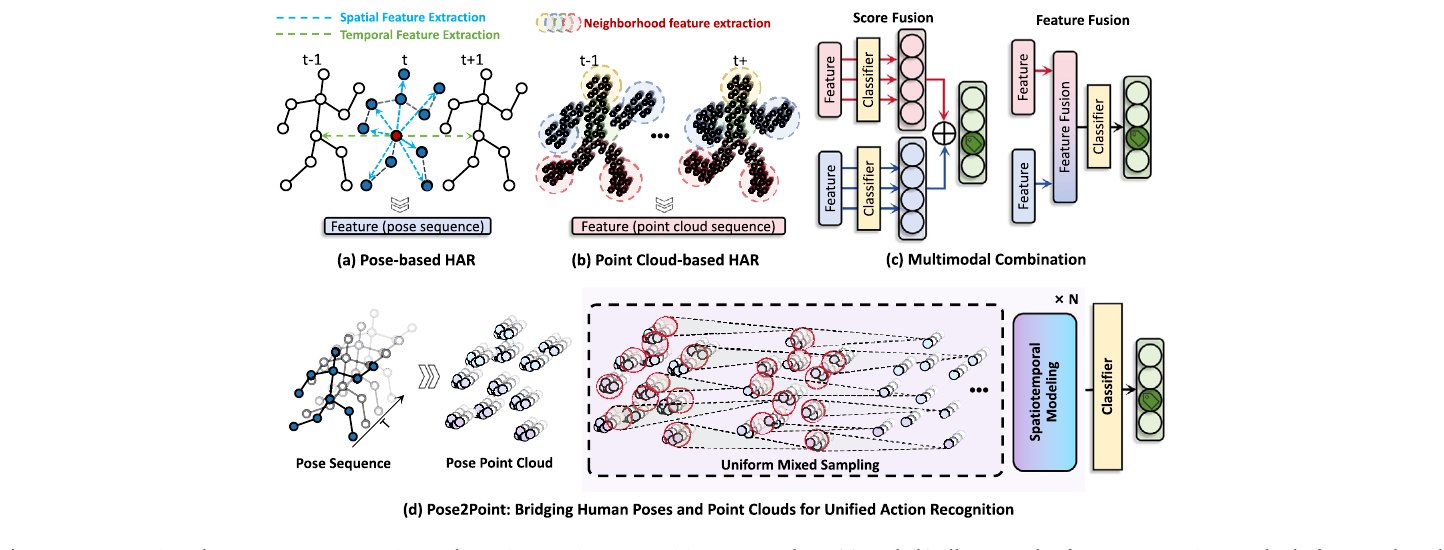
Figure 1: Pose2Point: Bridging human poses and point clouds for unified action recognition

Jiaying Lin, Jiajun Wen, Weiwei Wan, Mengyuan Liu*. Pose2Point: Bridging human poses and point clouds for unified action recognition. PR, 2026. (通讯作者, 模式识别期刊)

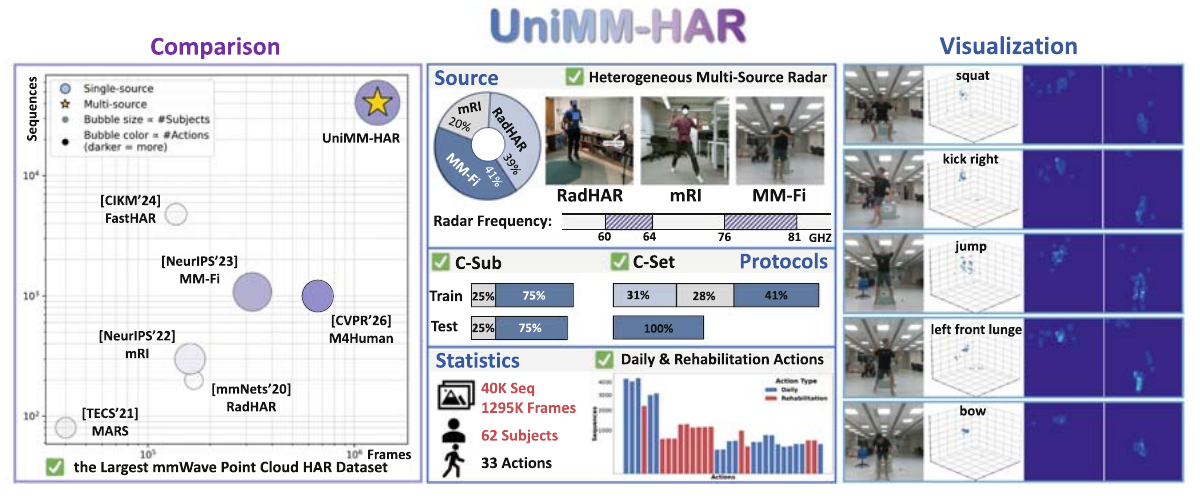
Figure 1: DAP: Doppler-aware Point Network for Heterogeneous
                            mmWave Action Recognition

Jiaying Lin, Shiman Wu, Jinfu Liu, Can Wang, Mengyuan Liu* . DAP: Doppler-aware Point Network for Heterogeneous mmWave Action Recognition. ECCV, 2026. (通讯作者, 计算机视觉顶会)
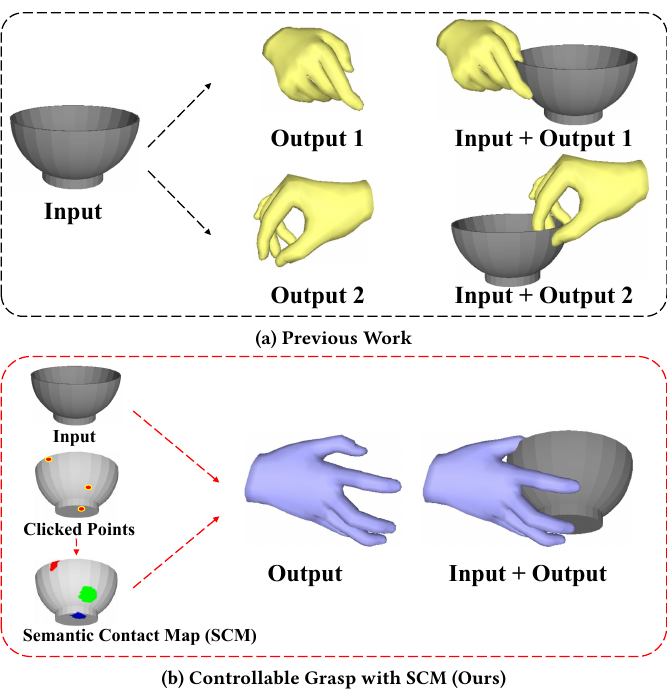
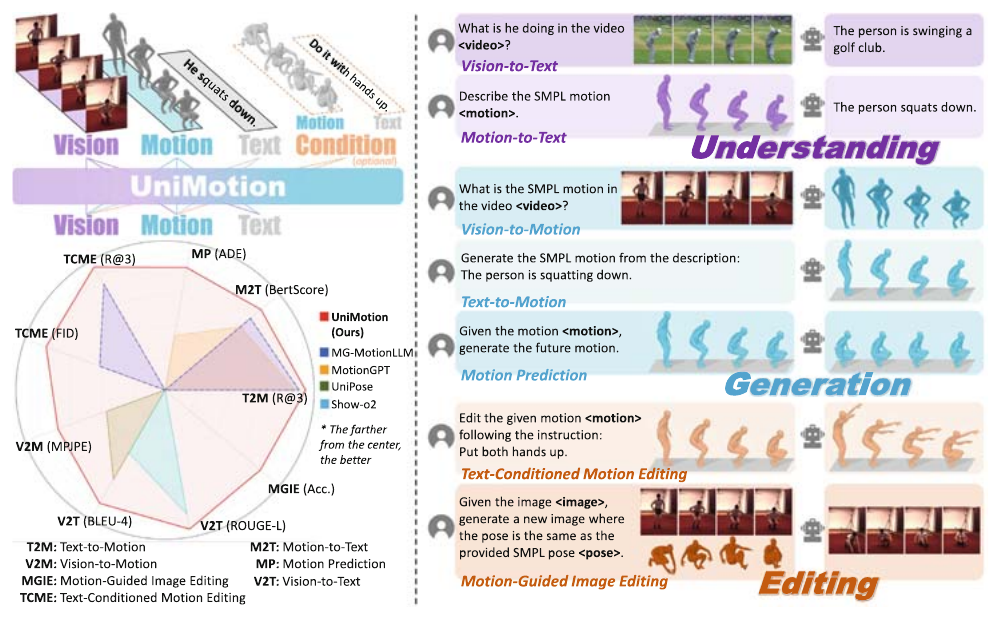
Figure 1: UniMotion: A Unified Framework for Motion-Text-Vision
                            Understanding and Generation

Ziyi Wang, Xinshun Wang, Chen Shuang, Cong Yang, Mengyuan Liu* . UniMotion: A Unified Framework for Motion-Text-Vision Understanding and Generation. ECCV, 2026. (通讯作者, 计算机视觉顶会)
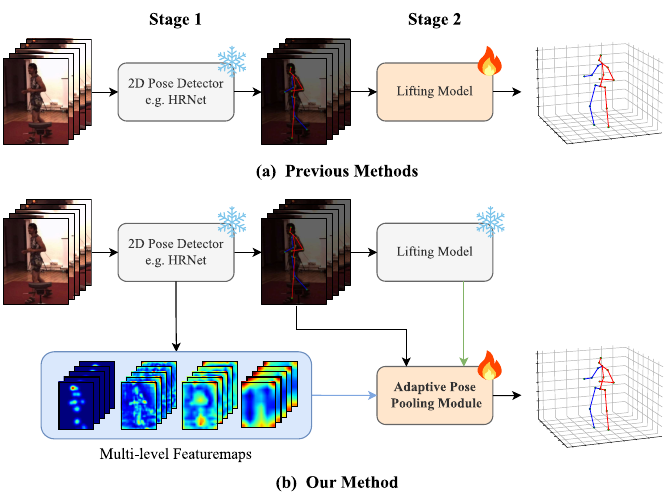
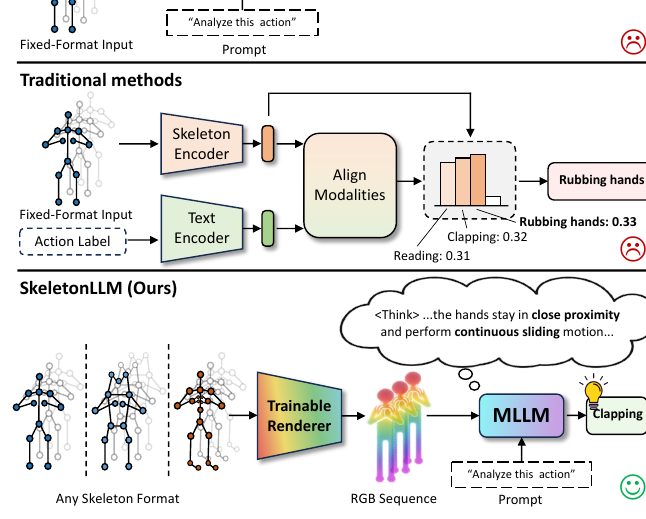
Figure 1: Universal Skeleton Understanding via Differentiable
                            Rendering and MLLMs

Ziyi Wang, Peiming Li, Xinshun Wang, Yang Tang, Kai-Kuang Ma, Mengyuan Liu* . Universal Skeleton Understanding via Differentiable Rendering and MLLMs. ICML, 2026. (通讯作者, 机器学习顶会)

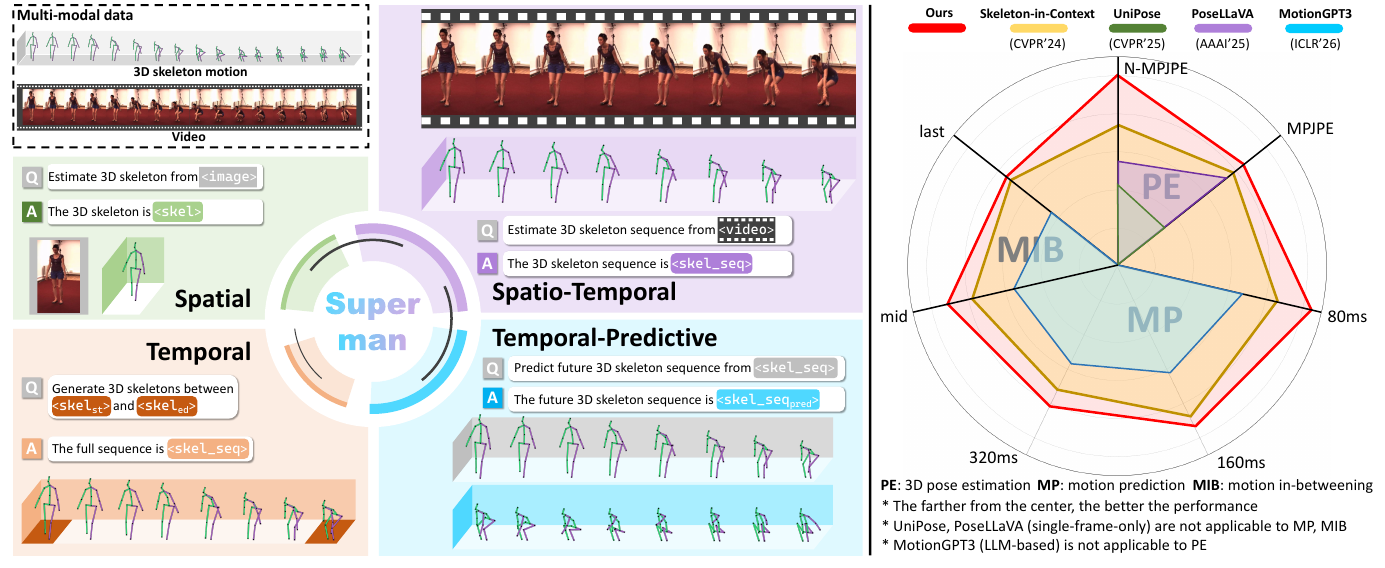
Figure 1: Superman: Unifying Skeleton and Vision for Human
                            Motion Perception and Generation

Xinshun Wang, Peiming Li, Ziyi Wang, Zhongbin Fang, Zhichao Deng, Songtao Wu, Xiangtai Li, Mengyuan Liu* . Superman: Unifying Skeleton and Vision for Human Motion Perception and Generation. CVPR, 2026. (通讯作者, 计算机视觉顶会)
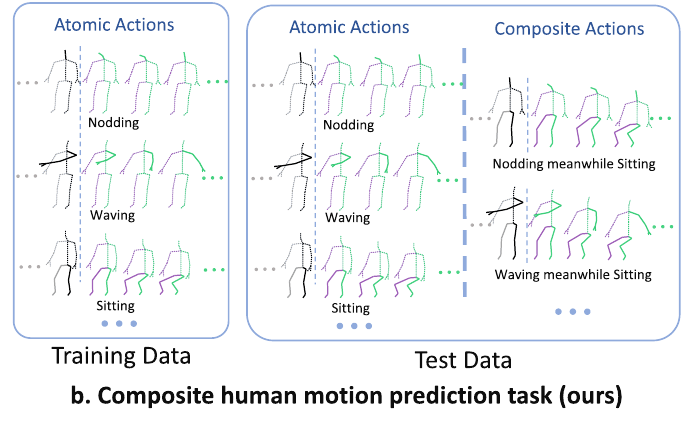
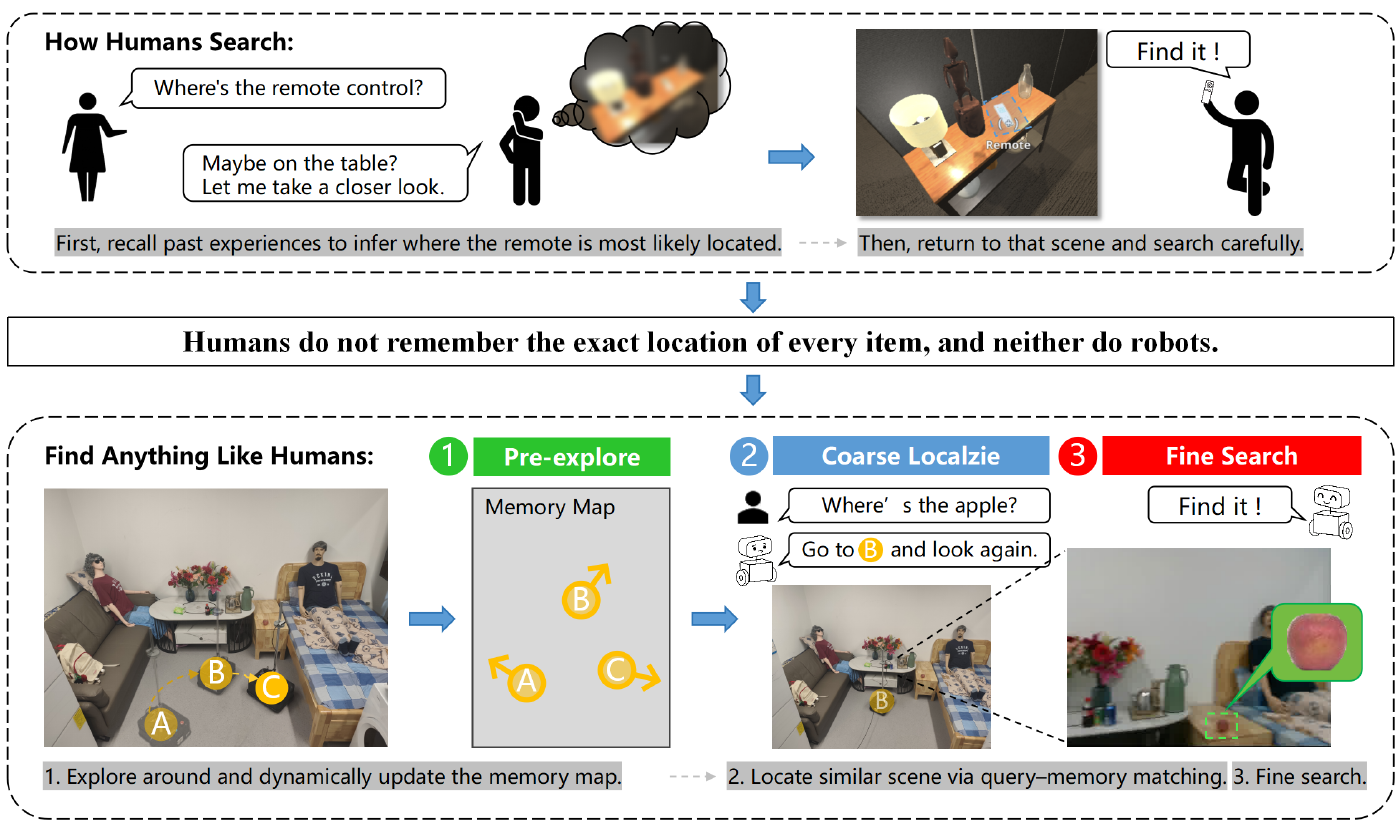
Figure 1: Find Anything Like Humans: Online Semantic Mapping
                            and Coarse-to-Fine Navigation in Dynamic Environments

Yutian Zhang, Jianyu Zhang, Mengyuan Liu* . Find Anything Like Humans: Online Semantic Mapping and Coarse-to-Fine Navigation in Dynamic Environments. ICRA, 2026. (通讯作者, 机器人顶会)

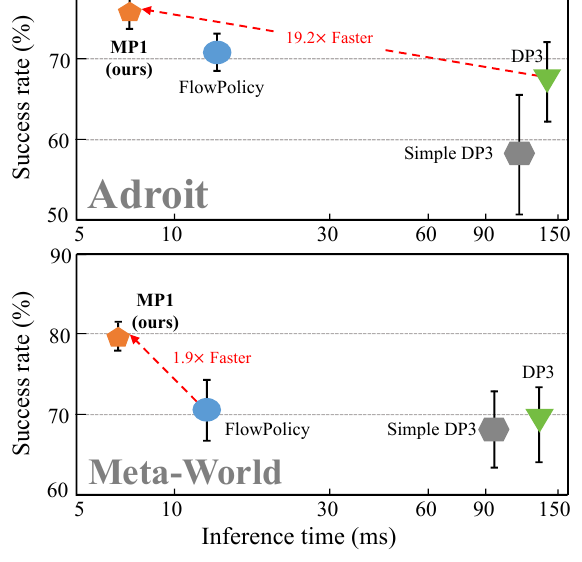
Figure 1: MP1: MeanFlow Tames Policy Learning in 1-step for
                            Robotic Manipulation

Juyi Sheng, Ziyi Wang, Peiming Li, Mengyuan Liu* . MP1: MeanFlow Tames Policy Learning in 1-step for Robotic Manipulation. AAAI, 2026. (通讯作者, 人工智能顶会)

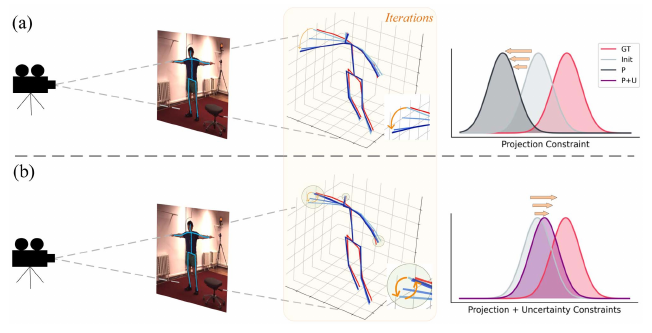
Figure 1: Uncertainty-Aware Testing-Time Optimization for 3D Human Pose Estimation

Ti Wang, Mengyuan Liu*, Hong Liu, Bin Ren, Yingxuan You, Wenhao Li, Nicu Sebe, Xia Li. Uncertainty-Aware Testing-Time Optimization for 3D Human Pose Estimation. TMM, 2026. (通讯作者, 多媒体期刊)

2025

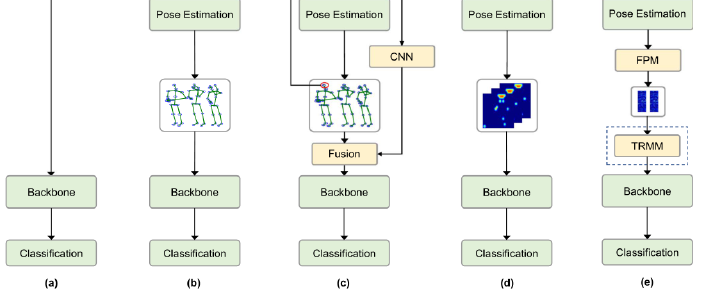
Figure 1: Heatmap Pooling Network for Action Recognition From RGB Videos

Mengyuan Liu, Jinfu Liu, Yongkang Jiang, Bin He. Heatmap Pooling Network for Action Recognition From RGB Videos. TPAMI, 2025. (第一作者, 计算机视觉顶刊)

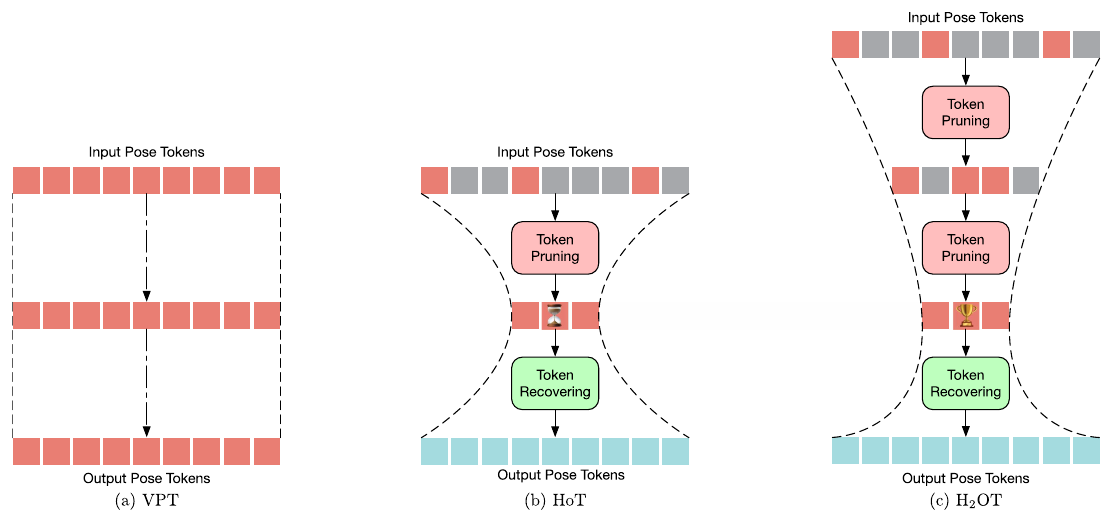
Figure 1: H2OT: Hierarchical Hourglass Tokenizer for Efficient Video Pose Transformers

Wenhao Li, Mengyuan Liu*, Hong Liu, Pichao Wang, Shijian Lu, Nicu Sebe. H2OT: Hierarchical Hourglass Tokenizer for Efficient Video Pose Transformers. TPAMI, 2025. (共同通讯作者, 计算机视觉顶刊)

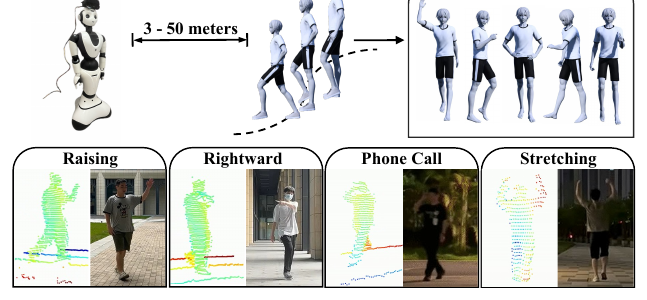
Figure 1: Recognizing Actions from Robotic View for Natural
                            Human-Robot Interaction

Ziyi Wang, Peiming Li, Hong Liu, Zhichao Deng, Can Wang, Jun Liu, Junsong Yuan, Mengyuan Liu* . Recognizing Actions from Robotic View for Natural Human-Robot Interaction. ICCV, 2025. (通讯作者, 计算机视觉顶会)
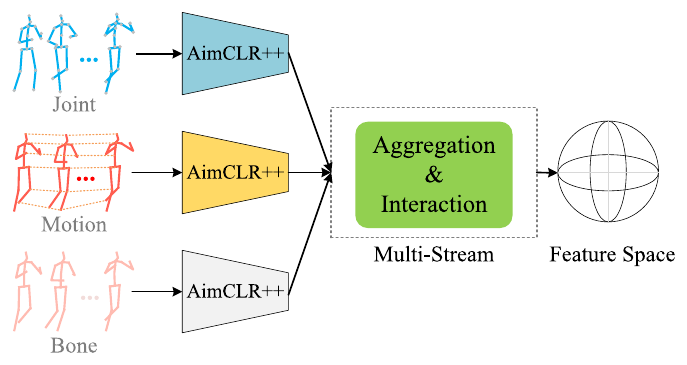
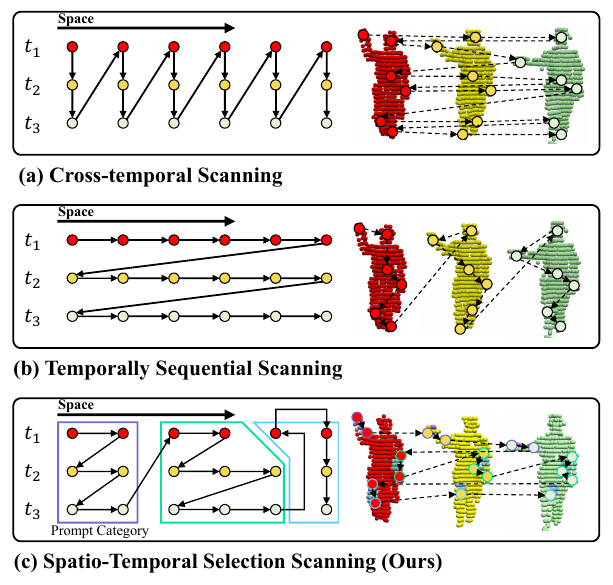
Figure 1: Ust-SSM: Unified Spatio-Temporal State Space Models
                            for Point Cloud Video Modeling

Peiming Li, Ziyi Wang, Yulin Yuan, Hong Liu, Xiangming Meng, Junsong Yuan, Mengyuan Liu* . Ust-SSM: Unified Spatio-Temporal State Space Models for Point Cloud Video Modeling. ICCV, 2025. (通讯作者, 计算机视觉顶会)
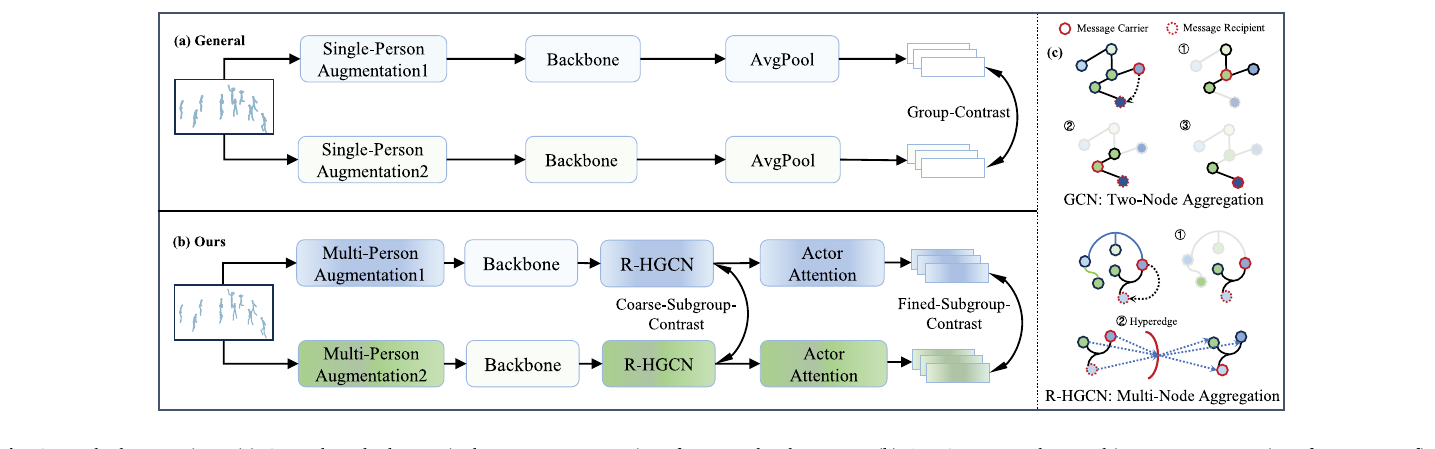
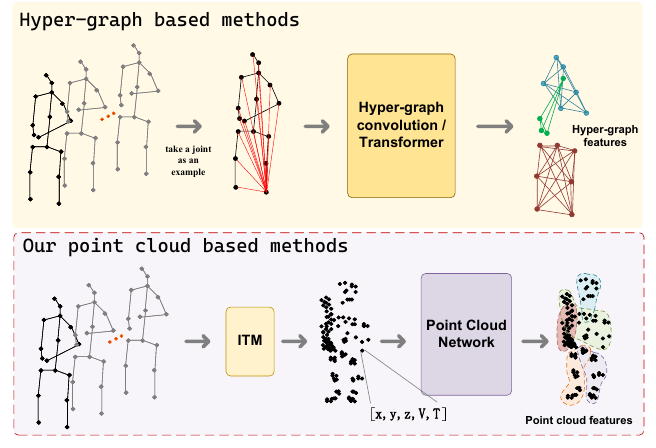
Figure 1: Recognizing Skeleton-Based Actions As Points

BaiqiaoYin, Jiaying Lin, Jiajun Wen, Yue Li, Jinfu Liu, Yanfei Wang, Mengyuan Liu*. Recognizing Skeleton-Based Actions As Points. IROS, 2025. (通讯作者, 机器人顶会)

Figure 1: Frequency-Aware Self-Supervised Group Activity Recognition with Skeleton Sequences

Guoquan Wang, Mengyuan Liu*, Hong Liu, Jinyan Zhang, Peini Guo, Ruijia Fan, Siyu Chen. Frequency-Aware Self-Supervised Group Activity Recognition with Skeleton Sequences. PR, 2025. (通讯作者, 模式识别期刊)

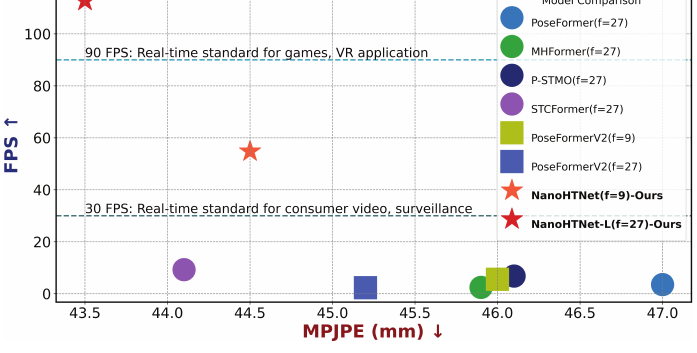
Figure 1: NanoHTNet: Nano Human Topology Network for Efficient 3D Human Pose Estimation

Jialun Cai, Mengyuan Liu*, Hong Liu, Wenhao Li, Shuheng Zhou. NanoHTNet: Nano Human Topology Network for Efficient 3D Human Pose Estimation. TIP, 2025. (通讯作者, 图像处理顶刊)

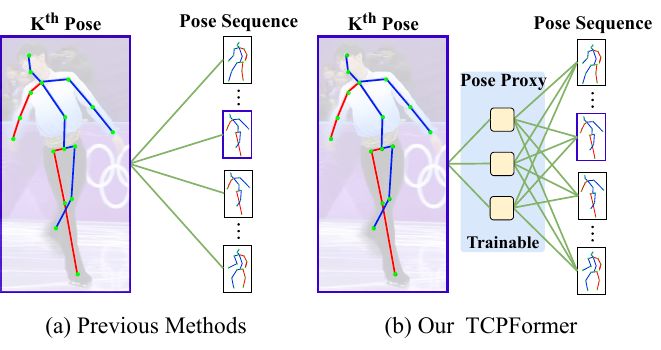
Figure 1: TcpFormer: Learning Temporal Correlation with
                            Implicit Pose Proxy for 3D Human Pose Estimation

Jiajie Liu, Mengyuan Liu* , Hong Liu, Wenhao Li. TcpFormer: Learning Temporal Correlation with Implicit Pose Proxy for 3D Human Pose Estimation. AAAI, 2025. (通讯作者, 人工智能顶会)

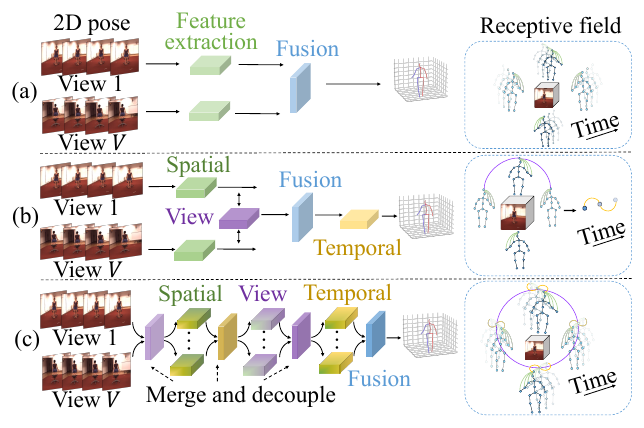
Figure 1: SVTformer: Spatial-View-Temporal Transformer for Multi-View 3D Human Pose Estimation

Wanruo Zhang, Mengyuan Liu*, Hong Liu, Wenhao Li. SVTformer: Spatial-View-Temporal Transformer for Multi-View 3D Human Pose Estimation. AAAI, 2025. (通讯作者, 人工智能顶会)

2024

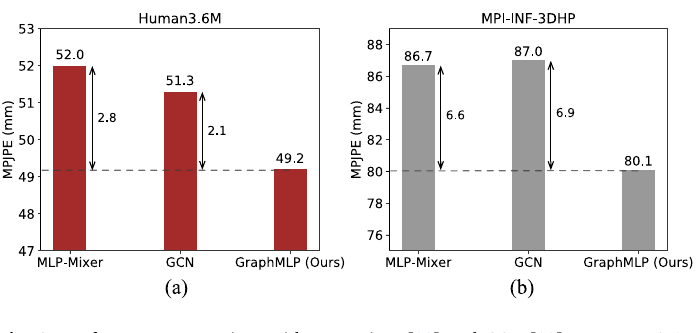
Figure 1: GraphMLP: A Graph MLP-Like Architecture for 3D Human Pose Estimation

Wenhao Li, Mengyuan Liu*, Hong Liu, Tianyu Guo, Ti Wang, Hao Tang, Nicu Sebe. GraphMLP: A Graph MLP-Like Architecture for 3D Human Pose Estimation. PR, 2024. (通讯作者, 模式识别期刊)

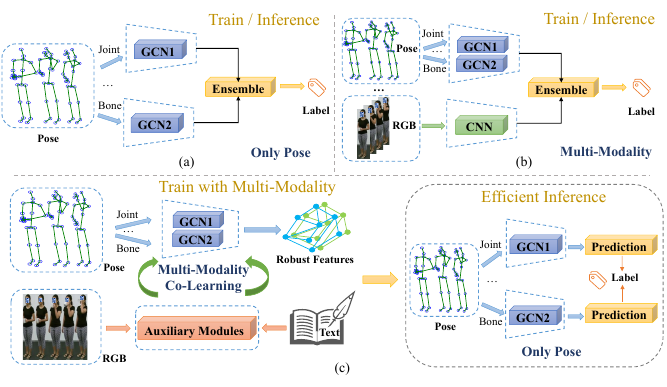
Figure 1: Multi-Modality Co-Learning for Efficient Skeleton-based Action Recognition

Jinfu Liu, Chen Chen, Mengyuan Liu*. Multi-Modality Co-Learning for Efficient Skeleton-based Action Recognition. ACM MM, 2024. (通讯作者, 多媒体顶会)

Figure 1: ClickDiff: Click to Induce Semantic Contact Map
                            for Controllable Grasp Generation with Diffusion Models

Peiming Li, Ziyi Wang, Mengyuan Liu* , Hong Liu, Chen Chen. ClickDiff: Click to Induce Semantic Contact Map for Controllable Grasp Generation with Diffusion Models. ACM MM, 2024. (通讯作者, 多媒体顶会)

Figure 1: APP: Adaptive Pose Pooling for 3D Human Pose
                            Estimation from Videos

Jinyan Zhang, Mengyuan Liu* , Hong Liu, Guoquan Wang, Wenhao Li. APP: Adaptive Pose Pooling for 3D Human Pose Estimation from Videos. ACM MM, 2024. (通讯作者, 多媒体顶会)

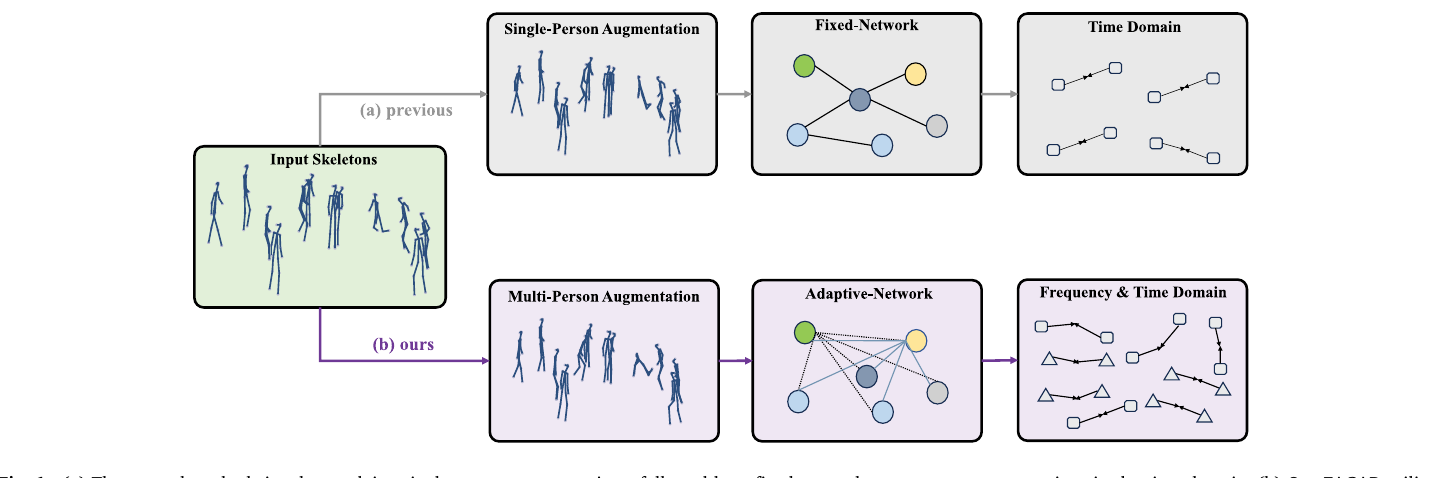
Figure 1: CHAMP: a large-scale dataset for skeleton-based composite human motion prediction

Wanying Zhang, Mengyuan Liu*, Xinshun Wang, Shen Zhao, Can Wang. CHAMP: a large-scale dataset for skeleton-based composite human motion prediction. TCSVT, 2024. (通讯作者, 视频技术期刊)

Figure 1: Improving Self-Supervised Action Recognition from Extremely Augmented Skeleton Sequences

Tianyu Guo, Mengyuan Liu*, Hong Liu, Guoquan Wang, Wenhao Li. Improving Self-Supervised Action Recognition from Extremely Augmented Skeleton Sequences. PR, 2024. (通讯作者, 模式识别期刊)

Figure 1: Augmented Skeleton Sequences with Hypergraph Network for Self-Supervised Group Activity Recognition

Guoquan Wang, Mengyuan Liu*, Hong Liu, Peini Guo, Ti Wang, Jingwen Guo, Ruijia Fan. Augmented Skeleton Sequences with Hypergraph Network for Self-Supervised Group Activity Recognition. PR, 2024. (通讯作者, 模式识别期刊)

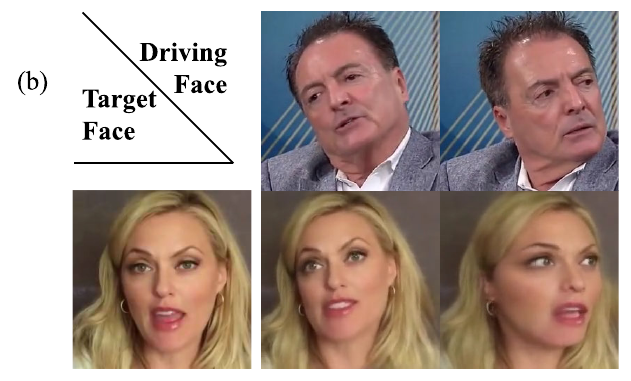
Figure 1: Facial Prior Guided Micro-Expression Generation

Yi Zhang, Xinhua Xu, Youjun Zhao, Yuhang Wen, Zixuan Tang, Mengyuan Liu*. Facial Prior Guided Micro-Expression Generation. TIP, 2024. (通讯作者, 图像处理顶刊)

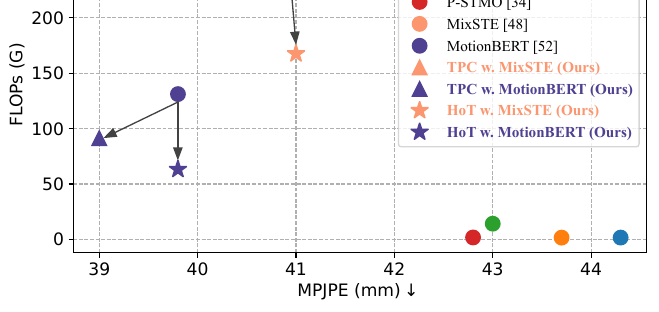
Figure 1: Hourglass Tokenizer for Efficient Transformer-Based 3D Human Pose Estimation

Wenhao Li, Mengyuan Liu*, Hong Liu, Pichao Wang, Jialun Cai, Nicu Sebe. Hourglass Tokenizer for Efficient Transformer-Based 3D Human Pose Estimation. CVPR, 2024. (通讯作者, 计算机视觉顶会)